Caso de éxito.
IA que detecta la somnolencia al volante: 80% de precisión sobre video real de cabina
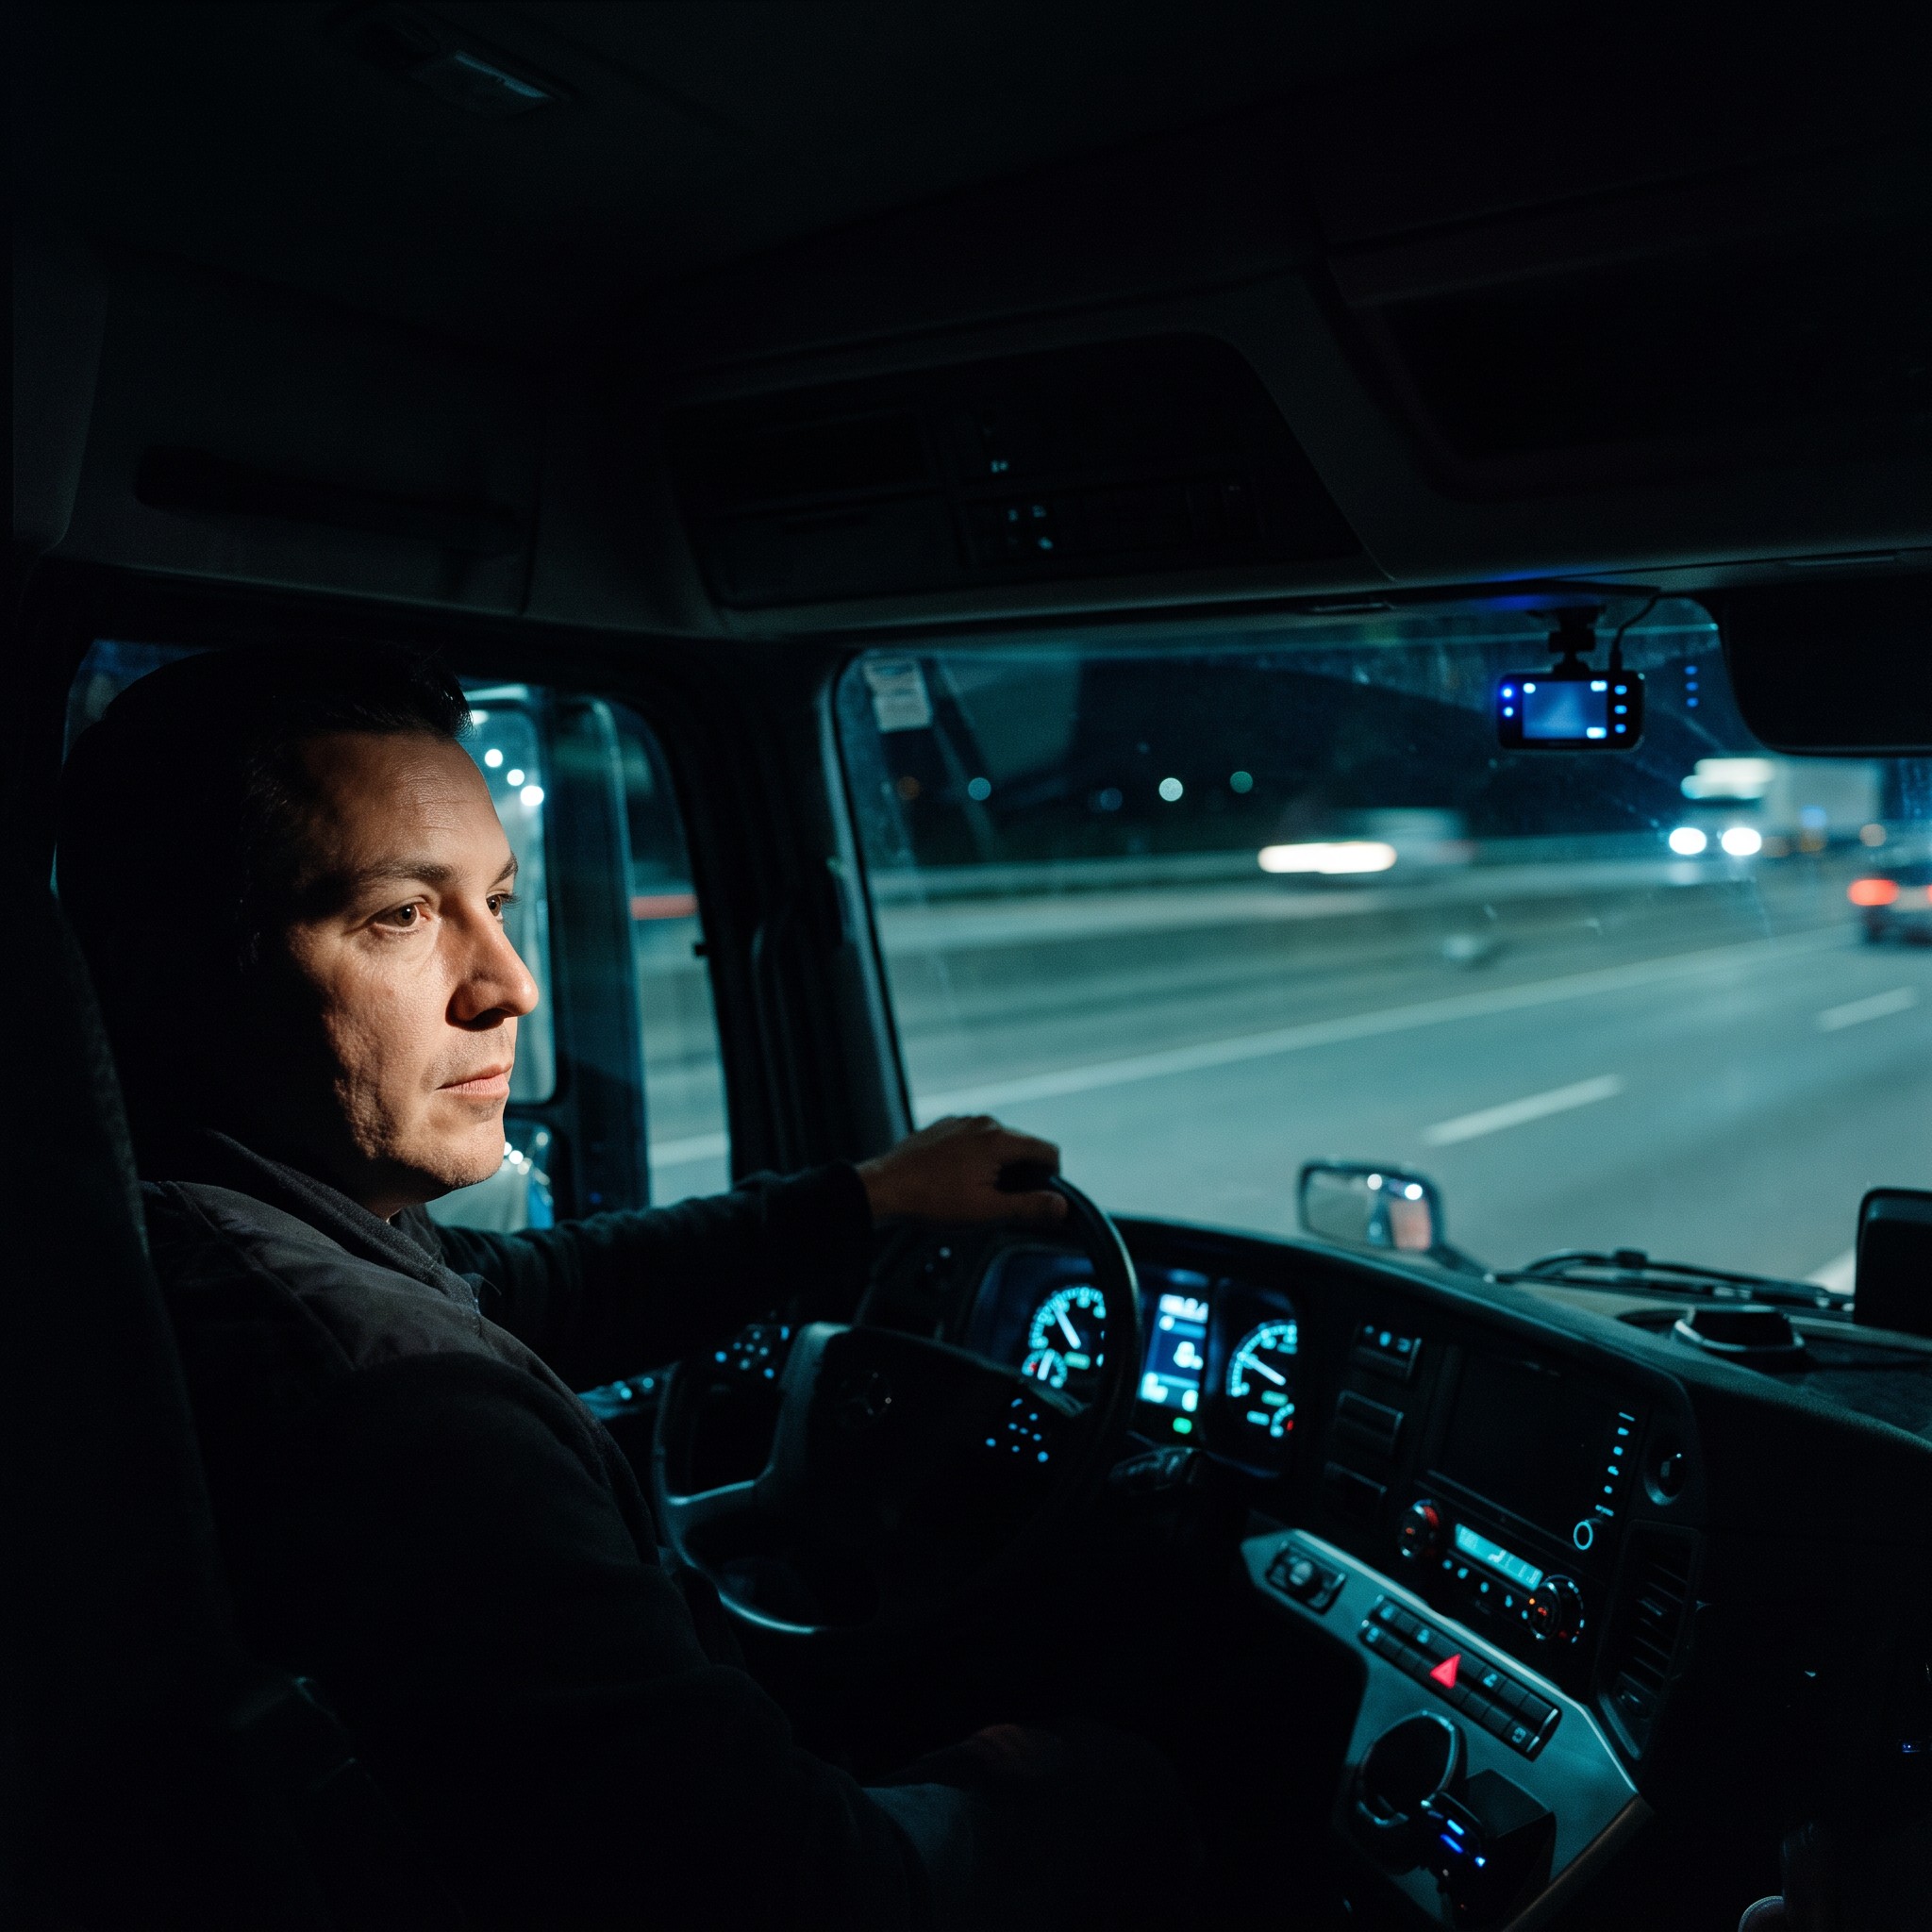
Cada año, la fatiga de los conductores de vehículos pesados cuesta vidas y siniestros. Las pausas obligatorias y las inspecciones periódicas ayudan, pero no muestran en tiempo real si el conductor está alerta, y ese riesgo permanece.
Nos ocupamos de cualquier desafío
En Zenta no hay obstáculos que no podamos vencer.
Desafío
Comprobar, técnica y económicamente, si un modelo de IA Generativa Visual-Lenguaje podía detectar con suficiente precisión señales de fatiga (cierre ocular, bostezos, movimiento de cabeza) sobre video real, manteniendo bajo control el costo de inferencia en GPU y con una arquitectura que incorporara nuevos modelos sin reingeniería.
Solución
Diseñamos y validamos una API de análisis de video con IA Generativa Visual-Lenguaje, 100% sobre Google Cloud. La arquitectura serverless orientada a eventos (Cloud Run, Pub/Sub, Firestore) usa dos modelos: Gemini 2.5 Flash para una pre-evaluación rápida que descarta videos no válidos y Qwen3-VL sobre GPU A100 para el análisis profundo. El pipeline es idempotente y trazable, con parámetros de inferencia ajustables para equilibrar precisión y costo, y publica el resultado vía Pub/Sub para integrarse con el sistema telemático de la flota (alarmas en cabina y aviso al centro de control).
Resultados con nuestra gestión

Precisión predictiva de 80% o más, cumpliendo el criterio de éxito acordado en el SOW.

Costo por análisis de USD 0,14 a 0,50 según volumen, dentro del rango de viabilidad definido.

Pipeline de punta a punta de ~41 segundos, con solo 2,23% de overhead no productivo (97% es análisis de IA).
Arquitectura modular validada: 3 modelos VL probados sin reingeniería, con 100% de trazabilidad por request en Firestore.